4 dk
Google SRE Bölüm 1 — Giriş
Neden Bu Seri?
Google'ın "Site Reliability Engineering" kitabı 2016'da yayımlandığında, bir şirketin production sistemlerini nasıl ayakta tuttuğuna dair bugüne kadarki en açık sözlü anlatımlardan biriydi. Aradan on yıl geçti. Ben kitabı ve beraberinde 3 seriyi dağınık zamanlarda okudum ve notlar aldım. Bugün sektörde yaptığım işlerin içerisinde de kullandım. Şimdi sizlere bunları bir seri ile anlatarak hem "kitap ne diyor" hem de "2026'da bu fikir nerede duruyor" sorusuna cevap arayalım isterim. Mevcut tecrübemle de yorumlayarak akademik ksıımları günlük problemlerimize entegre edeceğim. Keyifli okumalar dilerim.
İlk bölüm ("Introduction") kitabın manifestosu niteliğinde...
Sysadmin Modelinin Krizi
Google, kitaba klasik bir modeli tarif ederek başlıyor: bir şirket bir servis geliştirir, sonra bu servisi ayakta tutmak için ayrı bir "operations" (sysadmin) ekibi kurar. Bu ekip sistemi izler, sorun çıkınca müdahale eder — çoğunlukla elle, komut satırından script çalıştırarak.
Google'ın işaret ettiği iki temel kırılma noktası var:
Ölçeklenmeme sorunu. Sistem büyüdükçe, onu ayakta tutmak için gereken insan sayısı da doğru orantılı artıyor. Bu matematiksel olarak sürdürülemez bir model — servis 10 kat büyürse, ops ekibinin de 10 kat büyümesi gerekiyor demektir.
Motivasyon çatışması. Geliştirici ekip hız ve yeni özellik ister; ops ekibi ise istikrar ister, çünkü onun için her değişiklik potansiyel bir risktir. Bu doğal gerilim genelde ağır onay süreçleriyle "çözülmeye" çalışılır ki bu da her şeyi yavaşlatır.
Google'ın Cevabı: SRE
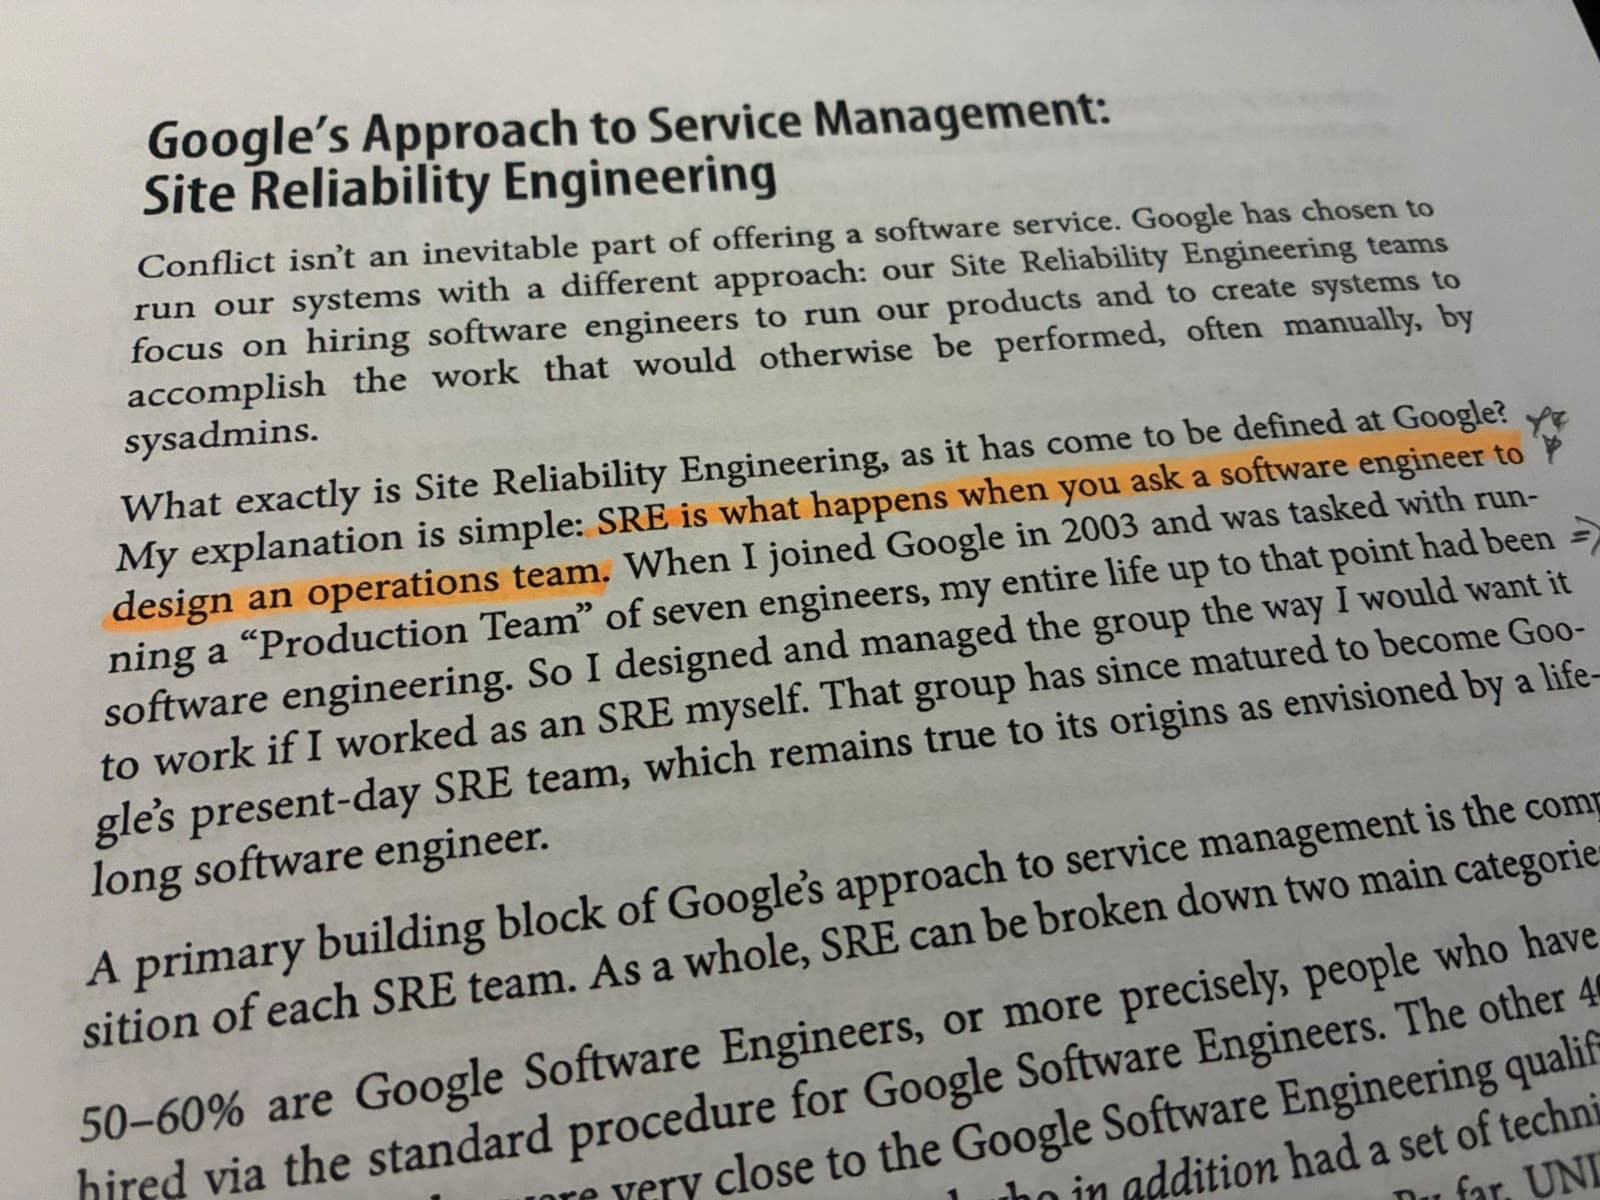
Kitabın en çok alıntılanan cümlesi tam olarak bu krizin cevabı: "SRE is what happens when you ask a software engineer to design an operations team." Ops işini klasik sistem yöneticilerine değil, yazılım mühendislerine yaptırıyorsun. Bu ekip otomasyona, script yazmaya, sistemi kod olarak yönetmeye eğilimli oluyor.
Burada Google'ın koyduğu somut ve sert bir sınır var: SRE'lerin operasyonel işe (Google'ın deyimiyle "toil" tekrar eden, otomatikleştirilebilir, kalıcı değer katmayan manuel iş) harcadığı zaman %50'yi geçmemeli. Kalan zaman mühendisliğe, araç geliştirmeye ayrılıyor. Bu bir öneri değil, bir tasarım kısıtı.
2026 Merceğinden: Ne Değişti, Ne Aynı Kaldı
Aradan on yıl geçti ve bu bölümün tezi hâlâ şaşırtıcı derecede sağlam duruyor ama manzara epey değişti.
Hâlâ birebir geçerli: Dev vs Ops gerilimi ortadan kalkmadı, sadece adı değişti. 2022 sonrası patlayan Platform Engineering akımı "golden path", "Internal Developer Platform (IDP)" gibi kavramlarla aslında SRE'nin bu ilk tezinin doğal bir devamı: Ops'u sistematik olarak mühendisliğe, kendi kendine hizmet eden platformlara dönüştürme çabası. Error budget ve toil kavramları da endüstri standardı haline geldi; Kubernetes, Terraform ve Crossplane ile günlük çalışan herkes bu kavramları artık sorgusuz kabul ediyor.
Google'ın öngöremediği kısım: 2016'da "otomasyon" demek script yazmak demekti. Bugün otomasyonun bir katmanı AI destekli anomali tespiti, otomatik root-cause analizi, "AI on-call copilot" ürünleri toil'i başka bir seviyede azaltmaya çalışıyor. Bu, kitabın %50 toil sınırı ilkesine yeni bir araç seti katıyor, ama beraberinde yeni bir risk de getiriyor: AI kararlarına aşırı güven.
Ayrıca sistem karmaşıklığı on yılda katlanarak arttı. 2016'nın "distributed systems" tanımı, bugünün mikroservis + Kubernetes + multi-cloud + serverless karmaşıklığının yanında oldukça sadeydi. Bu aslında kitabın tezini çürütmüyor, tam tersine güçlendiriyor: insan gücüyle ölçeklenmeme sorunu hafiflemedi, katlanarak büyüdü.
Son olarak, kitap yazıldığında SRE hâlâ biraz "sadece Google ölçeğinde mümkün" algısıyla anılıyordu. Zaten bu yüzden 2018'de gelen Workbook'un önsözünde bu algıyı kırma amacı açıkça yazıyor. 2026'da artık orta ölçekli şirketler, hatta bağımsız danışmanlık düzeyinde bile SRE pratikleri günlük iş haline geldi.
Sonuç
- Bölümde, SRE'nin "neden var olduğunu" anlatan bir felsefi giriş. On yıl sonra bakıldığında, teşhis (sysadmin modelinin ölçeklenmemesi) hâlâ doğru, çözüm (mühendislik disiplinini ops'a taşımak) hâlâ geçerli. Sadece araçlar (AI, Platform Engineering) ve ölçek (sistem karmaşıklığı, SRE'nin yaygınlaşması) değişti.
Bir sonraki yazıda Google'ın Production ortamını bir SRE'nin gözünden 2. Bölüm olarak anlatacağım.
Teşekkür ederim.