3 dk
Google SRE Bölüm 4 — Service Level Objectives
Chapter 3'te Error Budget kavramının tohumunu atmıştık. Chapter 4 bu fikri matematiksel bir zemine oturtuyor: SLI, SLO ve SLA — sektörde en çok karıştırılan ve hepimizin bir yerde muhakkak duyduğu üç terimi net bir şekilde açıklayalım.
SLI: Ölçüm
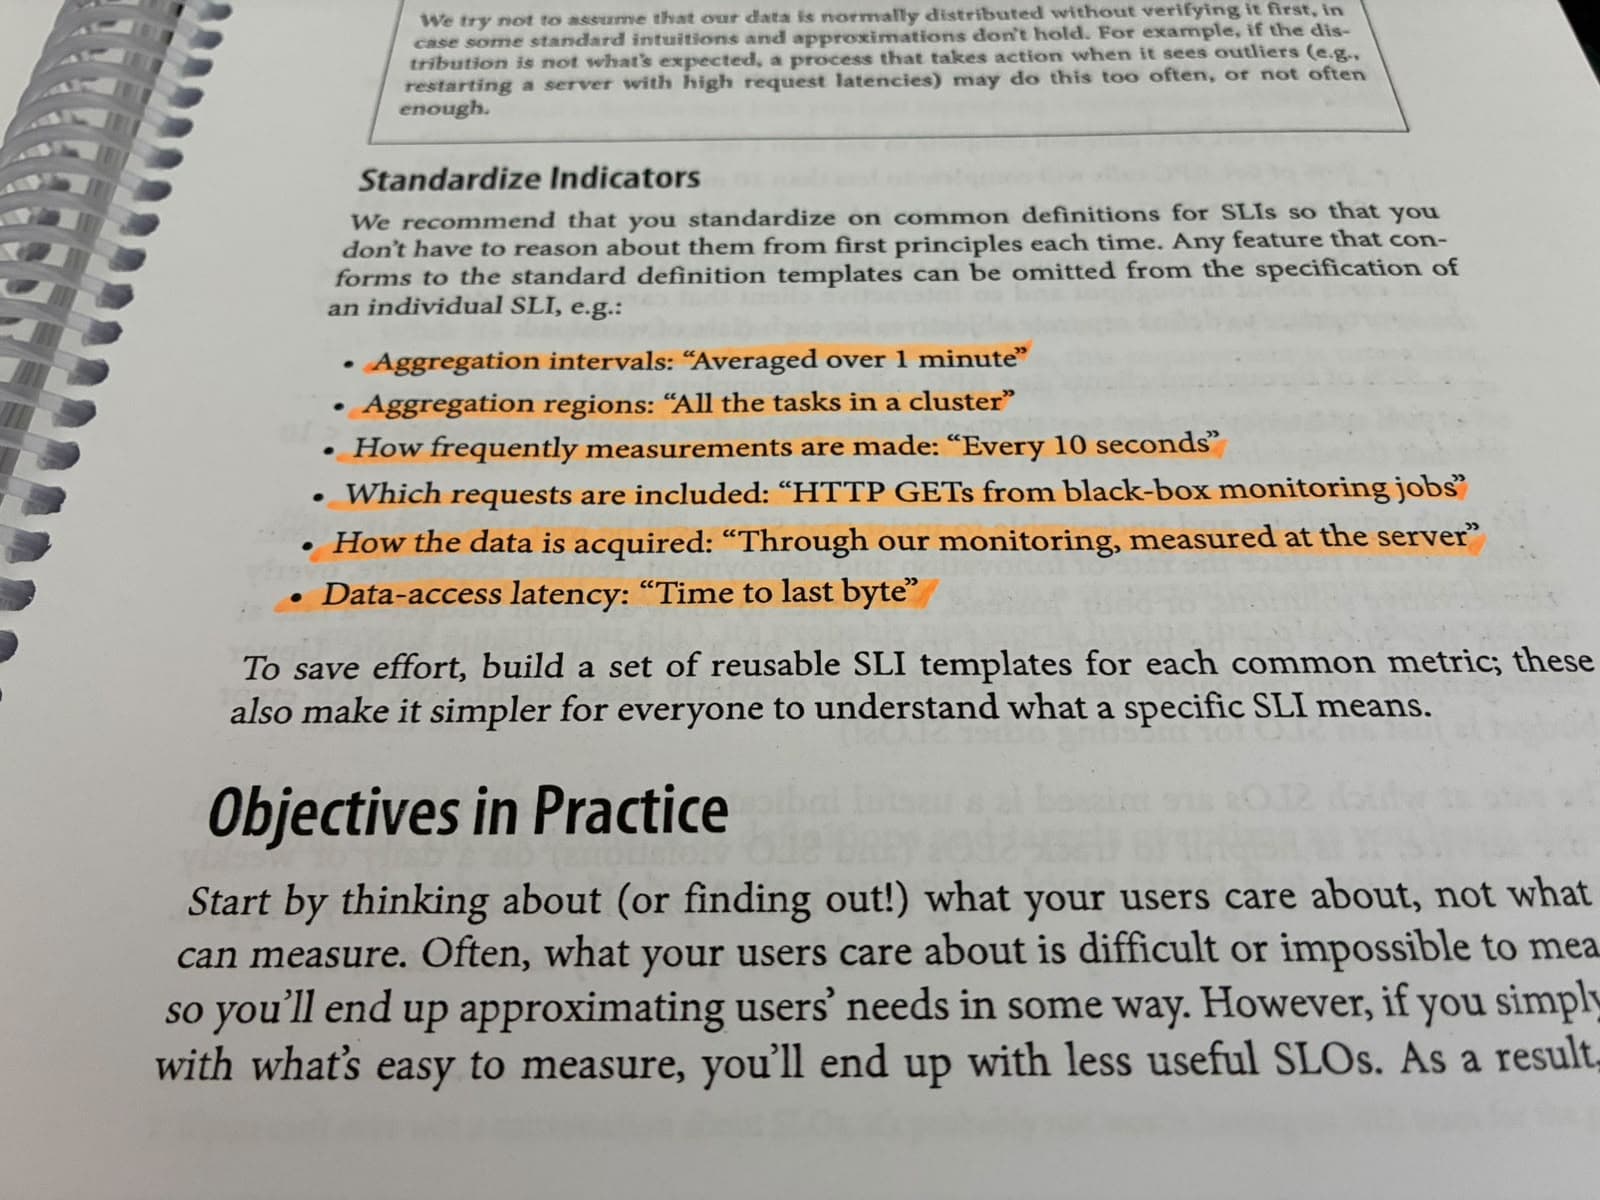
SLI (Service Level Indicator), bir servisin performansını gösteren somut, ölçülebilir bir metrik. Gecikme (latency), hata oranı, verim (throughput), kullanılabilirlik gibi örnekler var. Google'ın burada verdiği kritik uyarı şu: her metrik SLI değildir. SLI, kullanıcı deneyimini gerçekten yansıtan bir ölçüm olmalı. CPU kullanımı gibi bir sistem metriği genelde iyi bir SLI değil, çünkü kullanıcı CPU kullanımını değil, yavaşlığı hisseder.
SLO: Hedef
SLO, SLI için belirlenen hedef değer. "İsteklerin %99.9'u 200ms altında yanıtlansın" gibi. SLO, error budget'ın doğrudan kaynağı: SLO %99.9 ise, error budget otomatik olarak %0.1 oluyor. Google burada önemli bir pratik tavsiye veriyor: SLO'ları çok sıkı belirlememek. Gerçekte ulaşılabilecek performanstan daha sıkı bir SLO koymak, gereksiz mühendislik çabası ve gereksiz panik yaratıyor.
SLA: Sözleşme
SLA, SLO'nun müşteriyle yapılan resmi, genelde cezai yaptırımı olan hali. Google burada net bir ayrım çiziyor: SLA, SLO'dan daha gevşek tutulmalı çünkü SLA ihlali para iadesi ya da ceza demek, SLO ihlali ise "iç alarm, harekete geç" demek. Yani SLO'yu her zaman SLA'dan sıkı tutup, SLA'ya varmadan müdahale etme fırsatı yaratılıyor.
Doğru Metriği Seçmek
Google’ın değindiği bir başka nokta: Ölçümün nerede yapıldığı önemli. Sunucu tarafında mı, client tarafında mı ölçülüyor? Sunucu tarafı genelde ağ gecikmesini ve CDN sorunlarını kaçırıyor. Ayrıca ortalama yerine percentile'lara (p50, p95, p99) bakmak öneriliyor, çünkü ortalama kötü deneyim yaşayan azınlığı gizleyebiliyor.
2026 Merceğinden: Bu Bölüm Neden "Sıradan" Hissettiriyor
Açık konuşmak gerekirse bu bölümü okurken beklediğim derinliği bulamadım ve bunun aslında iyi bir haber olduğunu düşünüyorum. SLI/SLO/SLA ayrımı, percentile'a bakmak, ortalamaya güvenmemek: Bunların hepsi bugün herhangi bir mid seviye mühendisin günlük kelime dağarcığında. Ama bu "sıradanlığın" kendisi bir hikaye anlatıyor: 2016'da bu bölüm muhtemelen pek çok okuyucu için yeniydi. 2026'da bu kavramlar o kadar içselleşti ki artık "temel bilgi" kategorisinde bu da SRE pratiğinin on yılda ne kadar olgunlaştığının bir göstergesi.
Asıl fark bugün araçlarda. On yıl önce p99 gecikmeyi izlemek, bu bilgiyi doğru dashboard'a taşımak, burn rate'i hesaplamak ciddi bir mühendislik çabası gerektiriyordu. Bugün Grafana, Datadog, Prometheus'un SLO eklentileriyle bunlar birkaç tıkla kurulabiliyor hatta çoğu zaman "SLO as code" yaklaşımıyla Terraform/GitOps akışına dahi gömülebiliyor. Yani Google’ın anlattığı fikir değişmedi, ama fikri hayata geçirme maliyeti çöktü. Bu da belki de en büyük 2026 dersi: iyi bir fikir ile o fikri erişilebilir kılan tooling arasındaki mesafe kapandığında, o fikir "ileri seviye" olmaktan çıkıp "varsayılan" hale geliyor.
Sıradaki durakta Chapter 5'e geçiyoruz: Eliminating Toil — SRE'nin bir diğer temel kavramı.
Teşekkür ederim.