4 dk
Google SRE Bölüm 2 — Google'ın Production Ortamı, Bir SRE'nin Gözünden
İlk bölümde SRE'nin "Neden" var olduğunu konuşmuştuk. Kirabın ikinci bölümünde Google'ın altyapısının fiziksel ve mimari olarak nasıl işlediğine değineceğiz. Ben de sizlere bilgi birikimim ile yorumlamaya çalışacağım.
Donanım: Sıradan Makineler, Olağanüstü Yazılım
Google'ın veri merkezleri özel, pahalı, "kurumsal sınıf" donanımlardan oluşmuyor. Tam tersine, emtia (commodity) sunucular üzerine kurulu. Kitabın burada verdiği mesaj kitabın geri kalanının da omurgası: güvenilirlik, kusursuz çalışan tek bir makineden değil, hataları tolere edecek şekilde tasarlanmış yazılım katmanından geliyor. Elbette donanım arızalanabilir. Bu bir varsayım, bir istisna değil. Sistem bunun üzerine kurulu olmalı.
Bir Datacenter'ın İçi: Cluster, Borg, Depolama
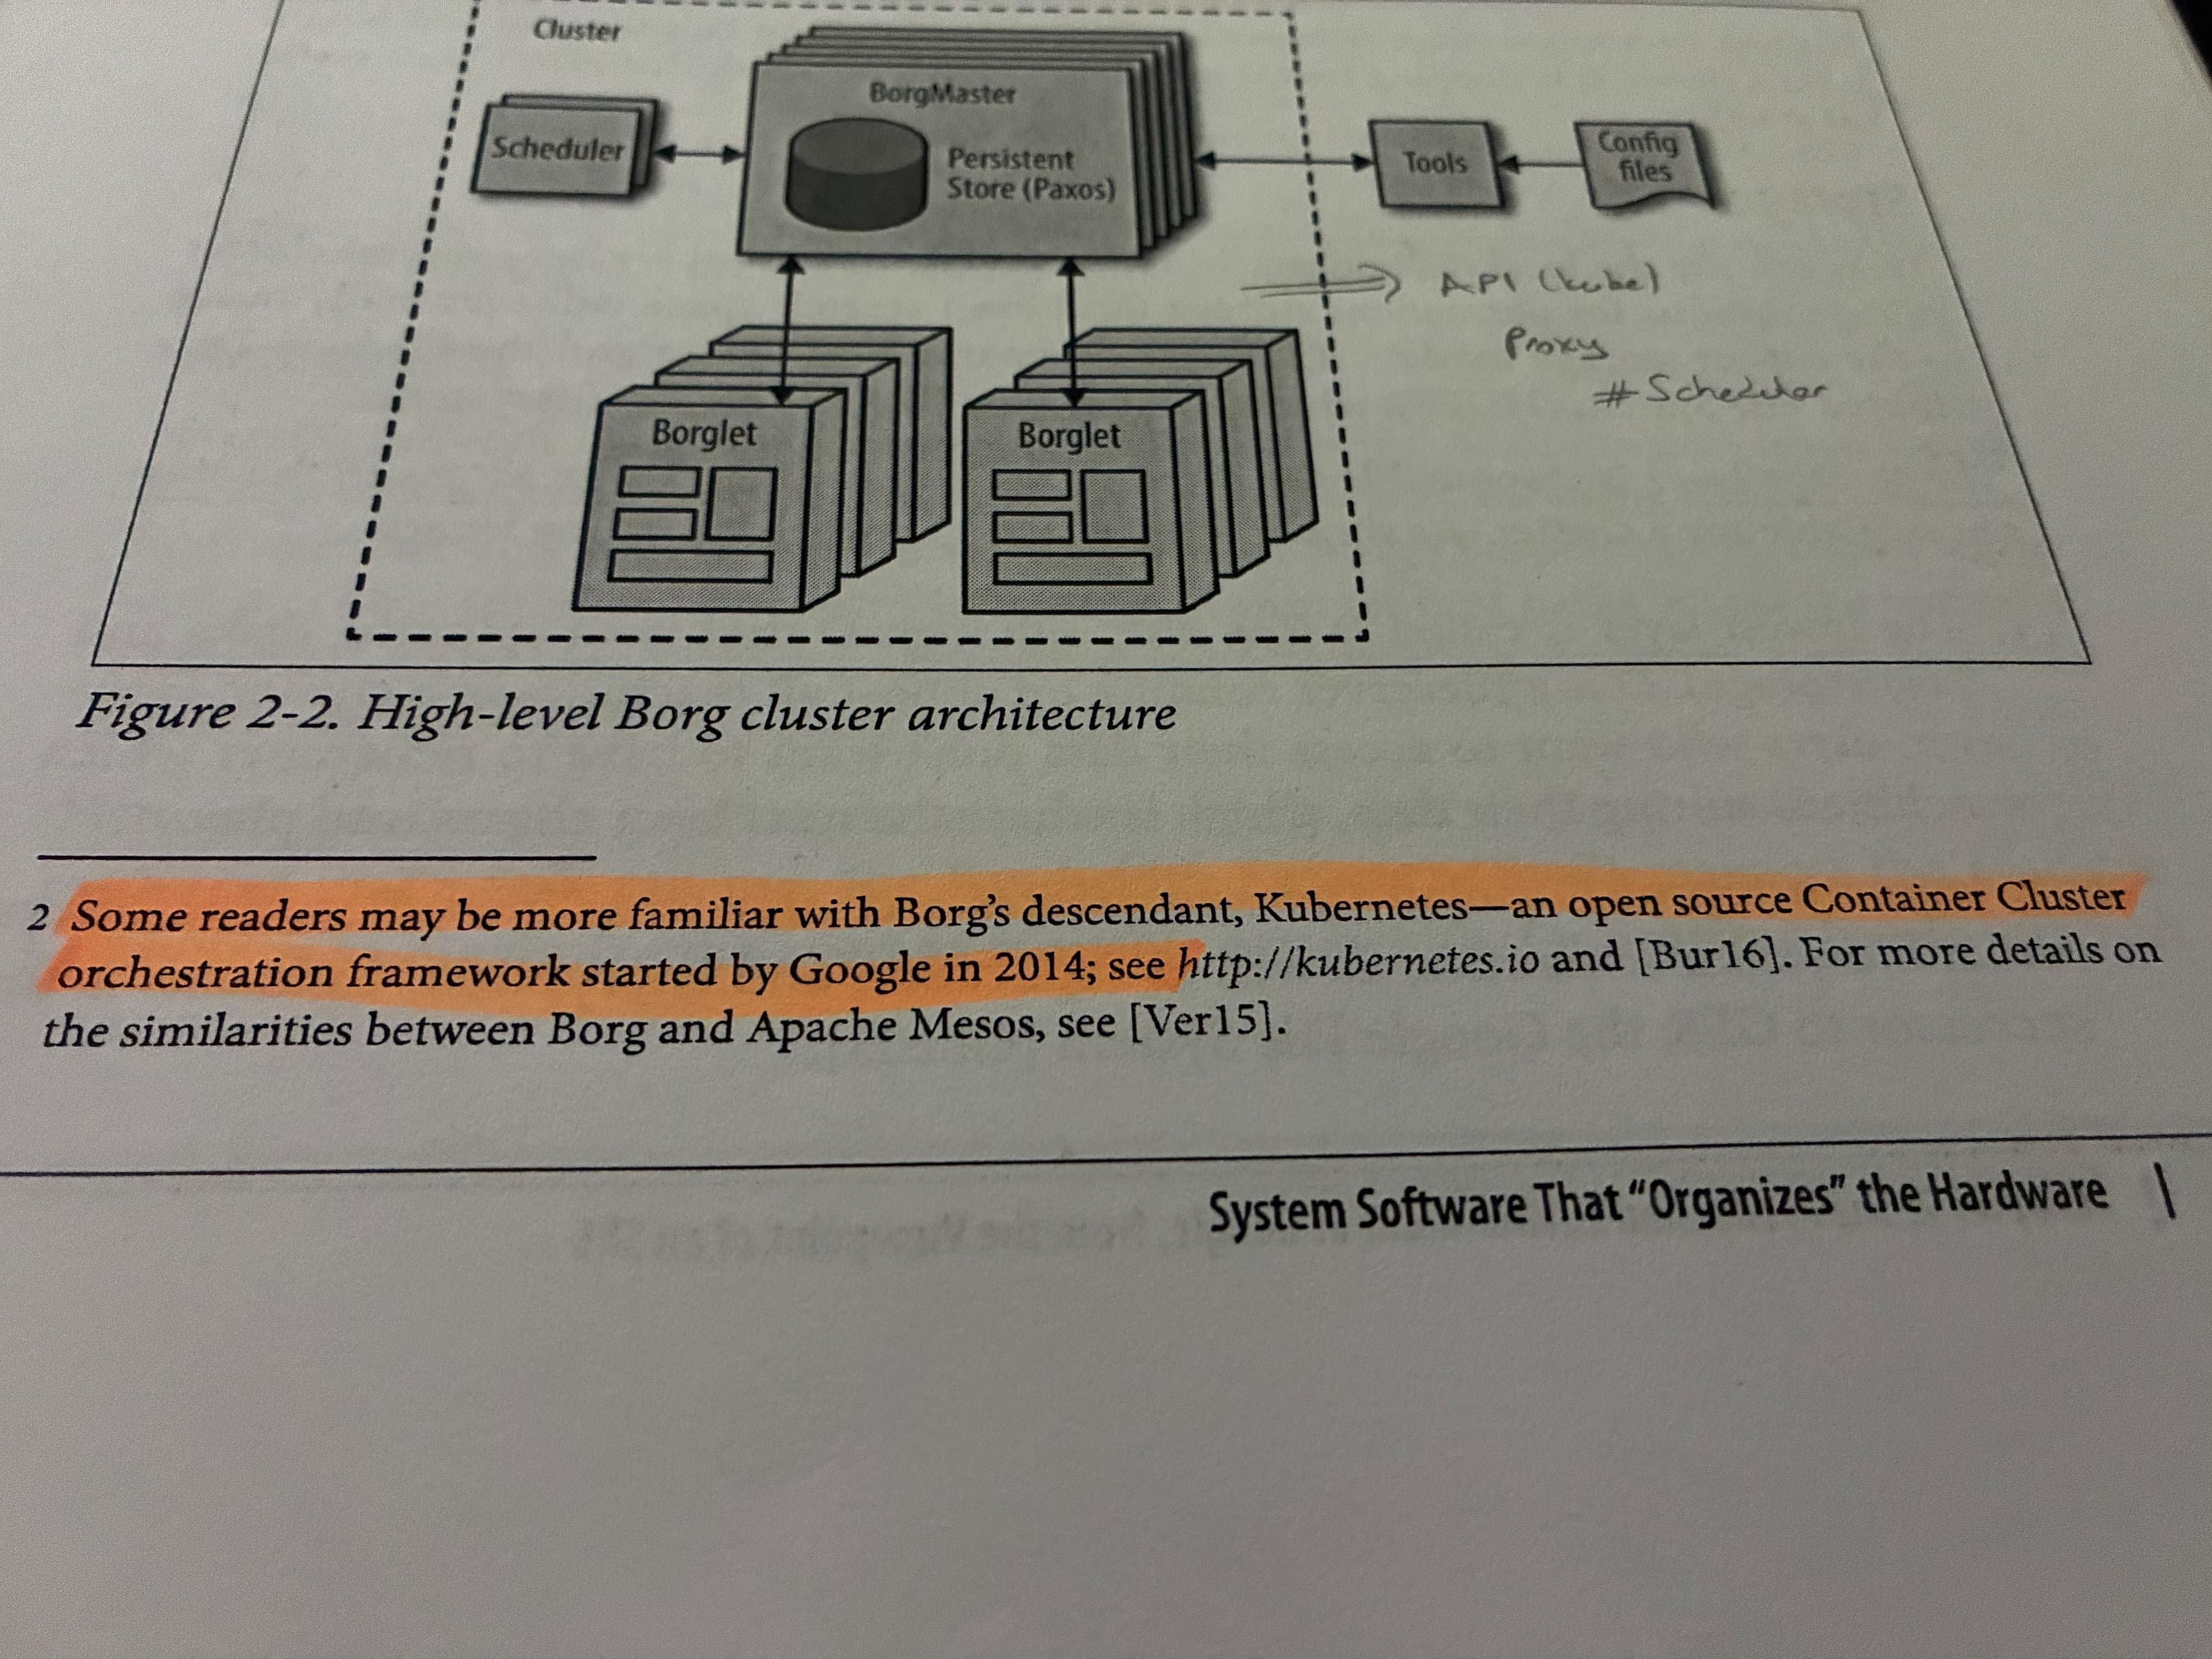
En temelde bildiğimiz gibi veri merkezindeki makineler cluster'lara ayrılıyor, ve bu cluster'lar Borg adlı bir sistem tarafından yönetiliyor. Borg'un işi tam olarak şu: hangi görevin (job/task) hangi makinede çalışacağına karar vermek, kaynak (CPU/RAM) tahsis etmek, bir görev çökerse onu yeniden başlatmak. Bugün bu cümleyi okuyan herkes aynı şeyi düşünecektir: bu, Kubernetes'in tarif ettiği şeyin ta kendisi, çünkü gerçekten de öyle, Borg, Kubernetes'in doğrudan atası ve ilham kaynağı.
Depolama tarafında ise Colossus var. Google'ın dağıtık dosya sistemi. Bunun üzerine kurulu Bigtable ve Spanner gibi dağıtık veritabanları da bu kısımda anılıyor; Spanner özellikle küresel ölçekte güçlü tutarlılık (strong Consistency) sağlamasıyla dikkat çekiyor.
Ağ: Google'ın Kendi Omurgası
Datacenter'lar birbirine ve dünyaya Google'ın kendi özel omurga ağı (Backbone Network) üzerinden bağlanıyor. İki farklı trafik türü var: datacenter'lar arası trafik, ve kullanıcıdan en yakın/en uygun datacenter'a yönlendirilen trafik. Bu ikinci kısım ileride load balancing bölümlerinde çok daha detaylı işlenecek.
SRE'nin Kullandığı Diğer Temel Yapı Taşları
Bölüm birkaç sistemi daha tanıtıyor, hepsi ileride tekrar tekrar karşımıza çıkacak:
- BNS (Borg Naming Service) : Servis keşfi (Service Discovery) katmanı
- Chubby : Dağıtık locking ve küçük konfigürasyon verisi için kullanılan sistem
- Protocol Buffers : Servisler arası veri serileştirme formatı
Neden Bu Bölüm Önemli
Bölümün asıl amacı bir "Harita" çizmek. Bir SRE, bir sorunla karşılaştığında mesela bir servis yavaşladığında sorunun donanımda mı? Netowrk'de mi?, Borg'un zamanlama kararında mı? Yoksa uygulama kodunda mı olduğunu ayırt edebilmeli. Bu ayrımı yapabilmek için sistemin her katmanının nasıl işlediğini bilmek gerekiyor. Bu yüzden bu bölüm, ileride gelecek troubleshooting ve monitoring bölümlerinin ön koşulu gibi düşünülebilir.
2026 Merceğinden: Aynı Fikirler, Farklı İsimler
Bu bölümü bugün yorumlamanın en çarpıcı tarafı, aradan geçen on yılda bu mimarinin kaybolmamış, tam tersine endüstri standardına dönüşmüş olması.
- Borg → Kubernetes. Bu artık sadece bir benzetme değil, doğrudan bir soy bağı. Borg'u tasarlayan mühendislerin bir kısmı Kubernetes'in de mimarları arasında. Bugün Kubernetes ile çalışan herkes, aslında on yıl önce Google'ın iç sistemi olan bir şeyin açık kaynak, topluluk tarafından geliştirilen halini kullanıyor.
- Chubby → etcd / ZooKeeper. Dağıtık kilitleme ve konfigürasyon deposu ihtiyacı hiç ortadan kalkmadı; bugün Kubernetes'in kendisi de arka planda etcd'ye dayanıyor.
- BNS → Kubernetes Service / DNS. Servis discovery problemi aynı, çözüm bugün cluster içi DNS ve Service objeleri üzerinden veriliyor.
- Spanner'ın mirası ise belki en ilginç olanı: 2012'de yayımlanan Spanner makalesi, "dağıtık sistemde küresel güçlü tutarlılık" konusunda sektörü değiştirdi. Bugün CockroachDB, YugabyteDB gibi açık kaynak projeler doğrudan Spanner'ın fikirlerinin üzerine kurulu.
Burada asıl ilginç olan şu: Google on yıl önce bu sorunları zaten çözmüştü, ama çözümler şirket içinde kilitli kaldı. Kubernetes'in 2014'te açık kaynak olarak yayımlanması, bu sırrı endüstriye açan asıl kırılma noktasıydı. Yani bu bölümü okurken aslında bugün her gün kubectl ile konuştuğumuz sistemin DNA'sını okuyoruz. Sadece on yıl önceki, henüz isimsiz haliyle.
Bir de şunu eklemek isterim: "Commodity Hardware + Akıllı Yazılım" felsefesi de bugün Cloud Native dünyanın temel varsayımı. AWS, GCP, Azure'da çalışan hiç kimse artık "hangi fiziksel makinede çalışıyorum" diye düşünmüyor. Bu soyutlama artık o kadar doğal ki, bu bölümün 2016'da bunu hâlâ açıklama ihtiyacı duyması bile başlı başına ne kadar yol kat edildiğinin göstergesi.
Sonuç
İkinci bölüm, kitabın geri kalanı için bir sözlük ve harita işlevi görüyor. Ama bugünden bakınca fark ediyoruz ki bu sadece Google'a özel bir sözlük değilmiş. Önümüzdeki on yılın tüm altyapı endüstrisinin konuşacağı dilin ilk taslağıymış.
Devamında Görüşmek Dileğiyle, Teşekkür Ederim.